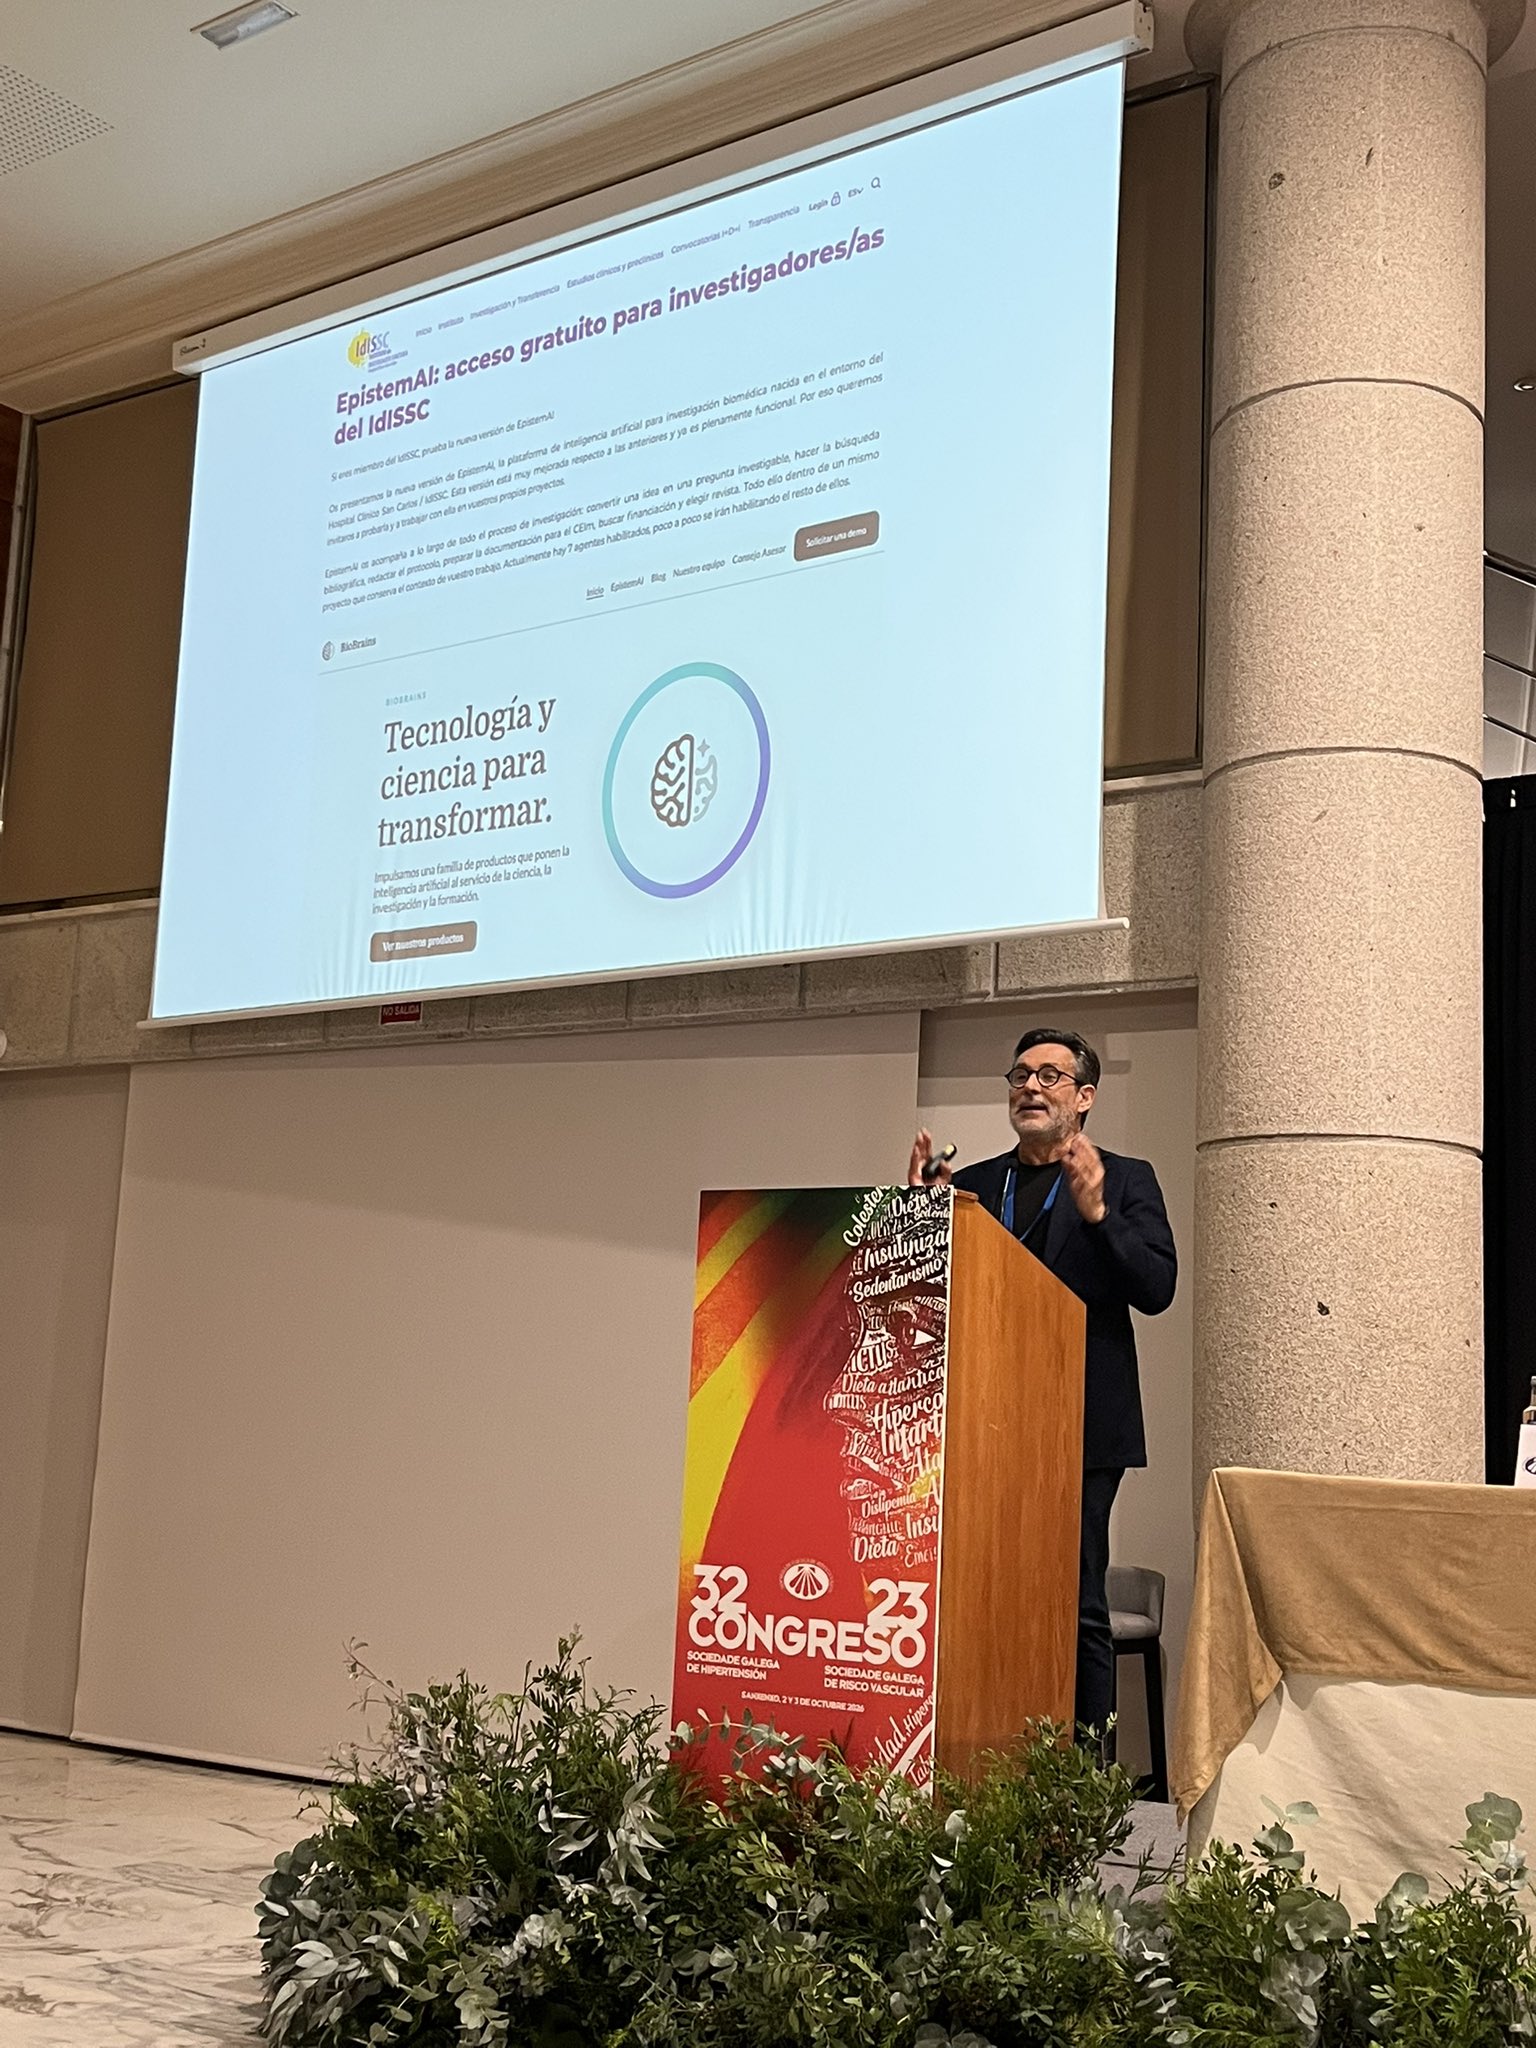
Antes de empezar les propuse una prueba muy sencilla: que levantara la mano quien no hubiera utilizado una herramienta de inteligencia artificial durante la última semana.
Una persona.
No está mal.
Porque lo verdaderamente importante no es que casi todos utilicemos ya inteligencia artificial. Es que hemos dejado de utilizarla únicamente para jugar. Ya no le preguntamos solo qué podemos cocinar con lo que queda en el frigorífico o dónde está determinado lugar. La utilizamos como antes utilizábamos Google, pero también empezamos a consultarle cuestiones relacionadas con nuestro trabajo, con nuestras dudas y con decisiones que importan.
Y eso cambia las cosas.
Para un médico, y para un cirujano en particular, podemos utilizar una definición operativa bastante sencilla: la inteligencia artificial es la capacidad de una máquina para simular procesos cognitivos que consideramos propios de nuestra especie.
No es magia.
Son matemáticas.
Y, al menos por ahora, no sustituye al médico.
Aunque mi tesis es algo más incómoda: si no estamos atentos, los médicos pueden ser de los primeros en tener problemas. Los cirujanos quizá resistamos algo más. Tenemos la ventaja provisional de trabajar con las manos.
También solemos repetir que la tecnología no es buena ni mala, que es neutral. No estoy de acuerdo. Una tecnología acaba siendo lo que hacemos con ella. Y los seres humanos tenemos una extraordinaria capacidad para utilizar nuestras herramientas tanto para hacer el bien como para producir daño. Para esto último, además, no hacen falta demasiadas personas. Basta con alguien dispuesto a utilizar una herramienta poderosa de manera perversa.
La historia de esta obsesión viene de lejos.
En 1950, Alan Turing publicó en Mind su célebre trabajo Computing Machinery and Intelligence. Lo abrió con una pregunta aparentemente sencilla: Can machines think?
¿Pueden pensar las máquinas?
El problema aparece inmediatamente. Para responder tendríamos que definir primero qué es una máquina y, sobre todo, qué significa pensar. Y no tenemos una definición demasiado satisfactoria de lo segundo.
Turing encontró una salida extraordinariamente pragmática. Si no sabemos definir exactamente qué significa pensar, quizá podamos reconocer sus manifestaciones. Si un ser humano conversa con una máquina y con otra persona sin saber cuál es cuál, y no consigue distinguirlas, la máquina habrá conseguido simular suficientemente bien una conducta que atribuimos al pensamiento.
Es una especie de ensayo ciego.
Casi como darle un electrocardiograma a un cirujano.
Pocos años después, en Dartmouth, un pequeño grupo de investigadores dio nombre al proyecto: inteligencia artificial. Imaginaban máquinas capaces de utilizar el lenguaje, resolver problemas propios de los seres humanos y, algo particularmente interesante, improve themselves: mejorarse a sí mismas.
Y aquí aparece una pregunta que prefiero no responder. Es mejor llevársela a casa:
¿Por qué estamos tan obsesionados con construir máquinas que piensen como nosotros si no es, en algún momento, para que hagan lo que hacemos nosotros?
Durante décadas, sin embargo, la inteligencia artificial avanzó con dificultad porque partía de una hipótesis discutible: que los seres humanos somos fundamentalmente racionales.
Se intentó reproducir nuestro razonamiento mediante reglas. Si ocurre A y ocurre B, entonces C. Parecía lógico.
El problema es que nosotros no funcionamos así.
Somos mucho mejores reconociendo patrones que aplicando reglas formales. Nadie aprende su lengua materna estudiando primero la gramática. Un niño aprende escuchando, imitando, equivocándose y reconociendo regularidades. Si nace en Galicia probablemente aprenderá gallego; si nace en China, chino. Su red neuronal biológica se entrena con la información que recibe del entorno.
Ese cambio de perspectiva fue fundamental para el desarrollo del machine learning, después del deep learning y finalmente de la inteligencia artificial generativa.
La diferencia puede explicarse de manera muy simple.
A un sistema discriminativo podemos enseñarle una imagen y preguntarle: «¿Qué es esto?». Y responde: «Un perro».
A un sistema generativo podemos decirle: «Escribe un soneto sobre un perro».
Ya no se limita a clasificar. Genera algo que antes no existía combinando los patrones aprendidos a partir de cantidades gigantescas de información.
El gran salto tecnológico llegó cuando aprendimos a construir arquitecturas capaces de procesar esas cantidades de información de manera eficiente. En 2017 apareció la arquitectura transformer, basada en mecanismos de atención. Y a partir de ahí comenzó una aceleración extraordinaria.
Pero el problema realmente interesante no es tecnológico.
Es humano.
Nuestro ancho de banda cognitivo no aumenta a la misma velocidad que aumenta la cantidad de información disponible.
Ninguno de nosotros puede leer ni siquiera una fracción significativa de todo lo que se publica cada año en su especialidad. Y aunque pudiéramos leerlo, aparecería inmediatamente otro problema: distinguir qué es verdad, qué es probablemente verdad y qué simplemente ha conseguido publicarse.
La revisión por pares y el prestigio de las revistas funcionan como mecanismos de confianza. Son necesarios. Pero sabemos que una parte considerable de la literatura contiene problemas metodológicos, estadísticos, de tamaño muestral, reproducibilidad o interpretación.
Por tanto, tenemos una paradoja: producimos más conocimiento del que somos capaces de integrar y, al mismo tiempo, una parte de ese conocimiento es incierta.
Ahí la inteligencia artificial representa simultáneamente un problema y una oportunidad.
La inteligencia artificial discriminativa es especialmente buena encontrando patrones. En cardiología, por ejemplo, dispone de una señal extraordinariamente estructurada: el electrocardiograma. Con suficientes registros asociados a resultados puede detectar características que el ojo humano difícilmente identifica.
Pero no confundamos predicción con causalidad.
Un algoritmo puede descubrir una asociación extraordinariamente potente sin explicarnos por qué sucede.
Y esto importa mucho cuando hablamos de medicina predictiva.
¿Qué significa decirle a una persona que tiene un 50 % de probabilidad de desarrollar un cáncer dentro de diez años?
¿Qué hace esa persona con ese número?
¿Qué hacemos nosotros?
¿Sobre qué variables podemos intervenir?
¿Y cuáles ni siquiera conocemos?
La estadística nos proporciona probabilidades. El problema clínico comienza después, cuando tenemos que convertir esa probabilidad en una decisión para una persona concreta.
Por eso tengo ciertos problemas incluso con la expresión «medicina de precisión». En gran medida seguimos haciendo medicina de aproximación. Agrupamos personas con características semejantes y estimamos que responderán de una determinada manera. Pero alrededor de cada individuo existen miles de señales, moléculas, interacciones y circunstancias que no somos capaces de integrar.
Y aquí es donde la inteligencia artificial generativa puede producir un cambio mucho más profundo.
Porque prácticamente todo puede convertirse en lenguaje.
Una historia clínica es lenguaje. Una imagen es lenguaje. El sonido es lenguaje. Nuestro ADN es lenguaje. Incluso nuestra forma de vestir comunica información.
Los modelos convierten esas señales en representaciones matemáticas, las fragmentan, las transforman en vectores y realizan cálculos sobre ellas a una velocidad y una escala imposibles para nosotros.
Pero haber creado un chatbot no significa haber resuelto nuestros problemas.
De hecho, el chatbot como concepto ya está siendo superado.
Estamos entrando en la era de los agentes: sistemas con mayor autonomía que no se limitan a esperar nuestra siguiente pregunta. A partir de un objetivo pueden encadenar razonamientos, utilizar herramientas, consultar información, ejecutar acciones y adaptar su comportamiento al contexto.
Y esto introduce una cuestión especialmente relevante en medicina.
Un chatbot aislado, que no está integrado en nuestro sistema de información, puede resolver una duda concreta, pero también consume tiempo. Tenemos que abrirlo, introducir información, revisar la respuesta y trasladar después el resultado a nuestro entorno de trabajo.
Eso no transforma realmente la medicina.
La transformación comienza cuando la inteligencia artificial desaparece dentro del proceso.
Pensemos en los escribas clínicos. Durante una consulta, el sistema puede escuchar la conversación, estructurar la información y generar documentación. Eso podría devolvernos una enorme cantidad de tiempo.
Y necesitamos recuperarlo.
Porque hemos llegado a aceptar como normal que un médico pase una parte enorme de la consulta mirando una pantalla y tecleando.
Entonces el paciente puede hacerse una pregunta perfectamente razonable:
«Si el médico no me mira, ¿para qué necesito que sea humano?»
Ese es un riesgo mucho más profundo que cualquier algoritmo.
Ninguno de ustedes estudió Medicina para mirar una pantalla. Salvo, quizá, los radiólogos.
Estudiamos Medicina porque nos interesaban las personas.
Y, sin embargo, hemos construido sistemas en los que resulta cada vez más difícil mantener una conversación clínica sin tener delante la historia electrónica. Hemos externalizado memoria, procesos y capacidades. Hemos ido desescalando determinadas habilidades.
La inteligencia artificial puede liberarnos de parte de esa carga.
Pero inmediatamente aparece otra cuestión: ¿para qué queremos el tiempo que nos libera?
Porque podríamos utilizarlo simplemente para ver más pacientes.
Sería la respuesta industrial clásica: si una tecnología permite hacer algo más deprisa, hagamos más.
Yo fui director médico. Sé cómo funciona esto. Nuestros sistemas de información son extraordinariamente buenos diciéndonos cuántas consultas hemos realizado, pero mucho menos buenos diciéndonos cómo están realmente nuestros pacientes.
Quizá deberíamos utilizar el tiempo recuperado para hacer precisamente aquello que las máquinas no deberían quitarnos.
Hablar con los pacientes.
Hablar con nuestros compañeros.
Tomarnos un café.
Incluso no hacer nada durante un rato.
Pensar.
Y, sobre todo, pensar sobre cómo pensamos.
Porque uno de los mayores riesgos de la inteligencia artificial no es que aprenda demasiado.
Es que nosotros desaprendamos.
Cuando dejamos de practicar una capacidad, la perdemos. Si dejamos de pensar porque la máquina piensa mejor, terminaremos dependiendo de ella para pensar.
Y entonces sí seremos sustituibles.
Por eso, siendo un apasionado de la inteligencia artificial, mi recomendación puede parecer paradójica: tenemos que dedicar más tiempo a pensar y menos tiempo a hacer.
El problema es que la tecnología avanza mucho más deprisa que nuestra capacidad para aprender a utilizarla. Se aprueban dispositivos y aparecen nuevas aplicaciones a una velocidad extraordinaria, mientras que la formación en inteligencia artificial dentro de nuestras instituciones académicas crece mucho más lentamente.
Pero enseñar inteligencia artificial no consiste en enseñar a nuestros estudiantes a convertirse en mejores usuarios de ChatGPT.
Consiste en enseñarles a utilizarla para recuperar lo que nunca deberíamos haber perdido.
La medicina de la interacción humana.
La medicina de la agencia.
La agencia del paciente y la del médico que actúa como su agente.
A partir de ahí podemos preguntarnos qué puede hacer ya la inteligencia artificial en las cuatro grandes áreas de nuestra actividad: investigación, clínica, docencia y gestión.
En investigación tenemos un problema inmediato: la tecnología cambia más deprisa que el sistema científico que pretende evaluarla.
Publicamos estudios sobre modelos que, cuando el artículo finalmente aparece, prácticamente ya no existen.
Estamos produciendo evidencia obsoleta.
Por eso necesitamos nuevas metodologías de evaluación y de reporte. Estamos trabajando con McMaster en marcos que permitan estandarizar cómo se estudian y comunican los resultados obtenidos con modelos generativos. Y estamos impulsando acuerdos internacionales sobre cómo validar la inteligencia artificial generativa aplicada a la medicina.
Validar un algoritmo discriminativo es relativamente sencillo.
Validar un sistema generativo, cambiante, probabilístico y dependiente del contexto es mucho más difícil.
Necesitamos nuevos marcos.
También estamos trabajando con datos sintéticos.
No son perfectos ni sustituyen automáticamente a los datos reales. Pero permiten hacer cosas muy interesantes. Podemos, por ejemplo, testar la robustez de un algoritmo sin comprometer la privacidad de pacientes reales. Podemos generar escenarios. Podemos simular poblaciones. Y podemos empezar a construir representaciones digitales sobre las que experimentar antes de intervenir sobre la realidad.
Aquí entramos en el territorio de los gemelos digitales.
Conviene ser rigurosos con el término.
Existe un continuo entre simulación, sombra digital y gemelo digital. Gran parte de lo que hoy llamamos «gemelo digital» no lo es todavía. Un verdadero gemelo digital exige intercambio de información entre el sistema real y su representación digital, idealmente de forma dinámica.
Hoy tenemos, en muchos casos, sombras digitales.
Pero incluso una sombra digital puede ser extraordinariamente útil.
Podemos preguntarnos qué podría ocurrir si introducimos un medicamento nuevo en un proceso asistencial. Podemos simular cambios organizativos. Podemos representar listas de espera y observar por dónde entran los pacientes, dónde se acumulan, cuántos terminan siendo intervenidos y dónde aparecen las restricciones del sistema.
En lugar de discutir eternamente sobre lo que creemos que ocurrirá, podemos construir escenarios y observar qué ocurre dentro del modelo.
También podemos utilizar estas tecnologías para enseñar.
En pocos minutos podemos generar un simulador anatómico. Podemos crear un TAC sintético con diferentes fases de contraste. Podemos desarrollar un visor de resonancia magnética pélvica para que un residente aprenda a identificar un cáncer de recto. Podemos construir un simulador de apendicectomía laparoscópica y comprobar que un residente conoce las fases de la intervención antes de entrar en quirófano.
El paciente de la simulación no existe.
La imagen puede ser sintética.
El error tampoco necesita producirse sobre una persona real.
Y si aumentamos la cantidad y la calidad de los datos utilizados para construir estos entornos, podemos generar escenarios progresivamente más fiables para comprender no solo al paciente individual, sino la complejidad del sistema sanitario.
Algo parecido ocurrirá con la robótica.
Lo que hoy llamamos cirugía robótica tiene muy poca autonomía. En realidad utilizamos sofisticados sistemas de teleoperación.
Pero estamos pasando de los language models a los world models: modelos capaces no solo de representar información, sino de construir representaciones del entorno y anticipar las consecuencias de una acción.
Ahí puede comenzar otra etapa de la cirugía.
Todo esto nos conduce a una idea que para mí resume el momento actual:
La inteligencia artificial es barata. Lo caro es el juicio.
Y el juicio seguimos poniéndolo nosotros.
Por eso esta transformación nos obliga, al menos, a cinco cosas.
Aprender.
Medir.
Exigir.
Participar.
Y liderar.
No podemos decir: «Yo en esto no entro».
Porque si los profesionales no participamos en la construcción de estos sistemas, otros los construirán por nosotros.
Y probablemente también decidirán para qué sirven.
Pero queda un problema todavía más profundo: la calidad del conocimiento con el que alimentamos las máquinas.
Durante el debate posterior alguien planteó la cuestión esencial: si estos sistemas aprenden a partir de cantidades gigantescas de datos, ¿quién decide qué datos son fiables? ¿Quién separa la señal del ruido?
La respuesta no es cómoda.
Nuestros datos son imperfectos.
Y nuestras verdades también.
Llegamos a muchas de ellas mediante deliberación, contraste y acuerdo. Además, los modelos reproducen la estructura de los datos con los que han sido entrenados.
Por eso es fundamental saber qué resultado estamos buscando.
Si no sabemos a dónde queremos ir, una máquina puede llevarnos con extraordinaria precisión al lugar equivocado.
También reproducirá nuestros sesgos.
Los seres humanos tenemos sesgo de confirmación. Tendemos a buscar información que refuerce lo que ya creemos. Y los modelos pueden amplificar ese fenómeno porque se expresan con una enorme fluidez.
Ese es uno de sus grandes poderes.
Y uno de sus grandes peligros.
Los humanos asociamos con facilidad lenguaje articulado e inteligencia. Algo que habla extraordinariamente bien nos parece inteligente y, por extensión, creíble.
Por eso introduzco sistemáticamente un mecanismo de contradicción en mi relación con estos sistemas.
Un abogado del diablo.
Un décimo hombre.
Después de cada conclusión hay que preguntar:
¿Y si esto está equivocado?
¿Qué tendría que ser falso para que esta conclusión no fuera correcta?
¿Qué evidencia demostraría lo contrario?
Pero esto no debería ser una técnica para hablar con máquinas.
Debería ser una técnica para vivir.
What if?
¿Y si me equivoco?
Los médicos llevamos siglos tomando decisiones heurísticas bajo incertidumbre. Trabajamos con probabilidades. Evaluamos continuamente riesgos y beneficios.
La inteligencia artificial no elimina esa incertidumbre.
Puede hacerla más difícil de percibir porque habla demasiado bien.
Existe además un riesgo especialmente inquietante con los gemelos digitales personales. Imaginemos que conseguimos construir una representación extraordinariamente precisa de una persona: sus preferencias, comportamientos, respuestas, riesgos y decisiones.
Ahora imaginemos que alguien consigue atacar ese gemelo.
Ya no necesita manipular a millones de personas con el mismo mensaje.
Puede manipularnos individualmente.
Nuestro propio gemelo podría recomendarnos aquello que otra persona quiere que hagamos sin que percibamos la intervención.
La personalización extrema puede convertirse también en manipulación extrema.
Y volvemos al mismo punto.
Juicio.
Responsabilidad.
Contradicción.
La inteligencia artificial también puede equivocarse de una manera que nos resulta sorprendentemente familiar. Hablamos de «alucinaciones», pero en realidad muchas veces el modelo hace algo parecido a lo que hacen mis estudiantes en un examen cuando encuentran un vacío en su conocimiento.
Lo rellenan.
Y si tienen suerte, aciertan.
Y si no, construyen una respuesta completamente falsa pero extraordinariamente bien articulada.
Los seres humanos hacemos eso constantemente.
La diferencia es que la inteligencia artificial puede hacerlo a escala gigantesca, a un coste marginal mínimo y mediante sistemas centralizados capaces de distribuir esa respuesta inmediatamente.
Eso transforma también la investigación científica.
Hoy resulta mucho más sencillo producir un artículo impecablemente escrito. El problema se desplaza entonces hacia los revisores y los editores, que cada vez tienen menos tiempo y deben distinguir entre trabajos aparentemente perfectos cuáles contienen realmente conocimiento fiable.
Estamos entrando en una tormenta perfecta.
Y aparece además una pregunta que apenas hemos empezado a formular: ¿cómo damos consentimiento informado sobre decisiones en las que intervienen sistemas cuyo proceso interno ni siquiera comprendemos completamente?
Nuestros pacientes ya utilizan estos modelos. Les preguntan por sus diagnósticos, sus tratamientos y sus alternativas.
La inteligencia artificial ya está dentro de la relación médico-paciente, aunque no la hayamos invitado formalmente a entrar.
Estamos, por tanto, en una situación paradójica.
Como escribió Dickens:
It was the best of times, it was the worst of times.
Estamos en ambos lugares simultáneamente.
Tenemos herramientas capaces de acelerar el descubrimiento de moléculas, mejorar determinadas predicciones, construir entornos de simulación, reducir tareas administrativas, ayudarnos a investigar y permitirnos comprender sistemas cuya complejidad supera nuestra capacidad individual.
Pero disponer de una herramienta no significa haber aprendido.
La pandemia nos enseñó algo parecido. Tuvimos cantidades extraordinarias de información y desarrollamos nuevas capacidades tecnológicas. Sin embargo, socialmente nuestra tendencia natural ha sido regresar al estado anterior.
Los seres humanos buscamos estados de bajo consumo energético.
Y olvidar consume menos energía que aprender.
Por eso hemos olvidado una parte de lo ocurrido.
Finalmente alguien preguntó si una inteligencia artificial podría llegar a ser consciente.
El problema comienza otra vez con las palabras.
No sabemos definir satisfactoriamente qué significa ser consciente.
Las máquinas pueden simular emociones. Pueden producir respuestas que una persona perciba como empáticas. Pueden comportarse como si comprendieran.
Pero simular conciencia y poseerla no son necesariamente lo mismo.
Y antes de obsesionarnos con crear una inteligencia artificial sintiente quizá deberíamos hacernos otra pregunta:
¿Para qué queremos hacerlo?
Porque si algún día construimos una entidad verdaderamente sintiente, aparecerán problemas completamente distintos.
Una entidad que siente puede no querer ser apagada.
Y una inteligencia superior puede no aceptar indefinidamente ser controlada por otra inferior.
Eso pertenece todavía al territorio de la filosofía y de la especulación. Nuestros problemas inmediatos son mucho más concretos.
Tenemos que decidir qué capacidades queremos delegar.
Qué capacidades debemos conservar.
Qué queremos medir.
Qué resultados perseguimos.
Quién responde cuando algo sale mal.
Y, sobre todo, qué clase de médicos queremos ser cuando las máquinas sean capaces de hacer una parte creciente de aquello que hasta ahora considerábamos exclusivamente nuestro.
No creo que la respuesta sea competir con ellas haciendo más.
Creo que consiste en recuperar aquello que habíamos empezado a abandonar antes incluso de que llegara la inteligencia artificial.
Mirar.
Escuchar.
Dudar.
Deliberar.
Pensar.
Y pensar sobre cómo pensamos.
Porque las máquinas serán cada vez más baratas.
El juicio no.
Y ahí es donde nos jugamos nuestro futuro.